Todos los proyectos

Asistente RAG de Manufactura

Demo independiente y abierta de generación aumentada por recuperación

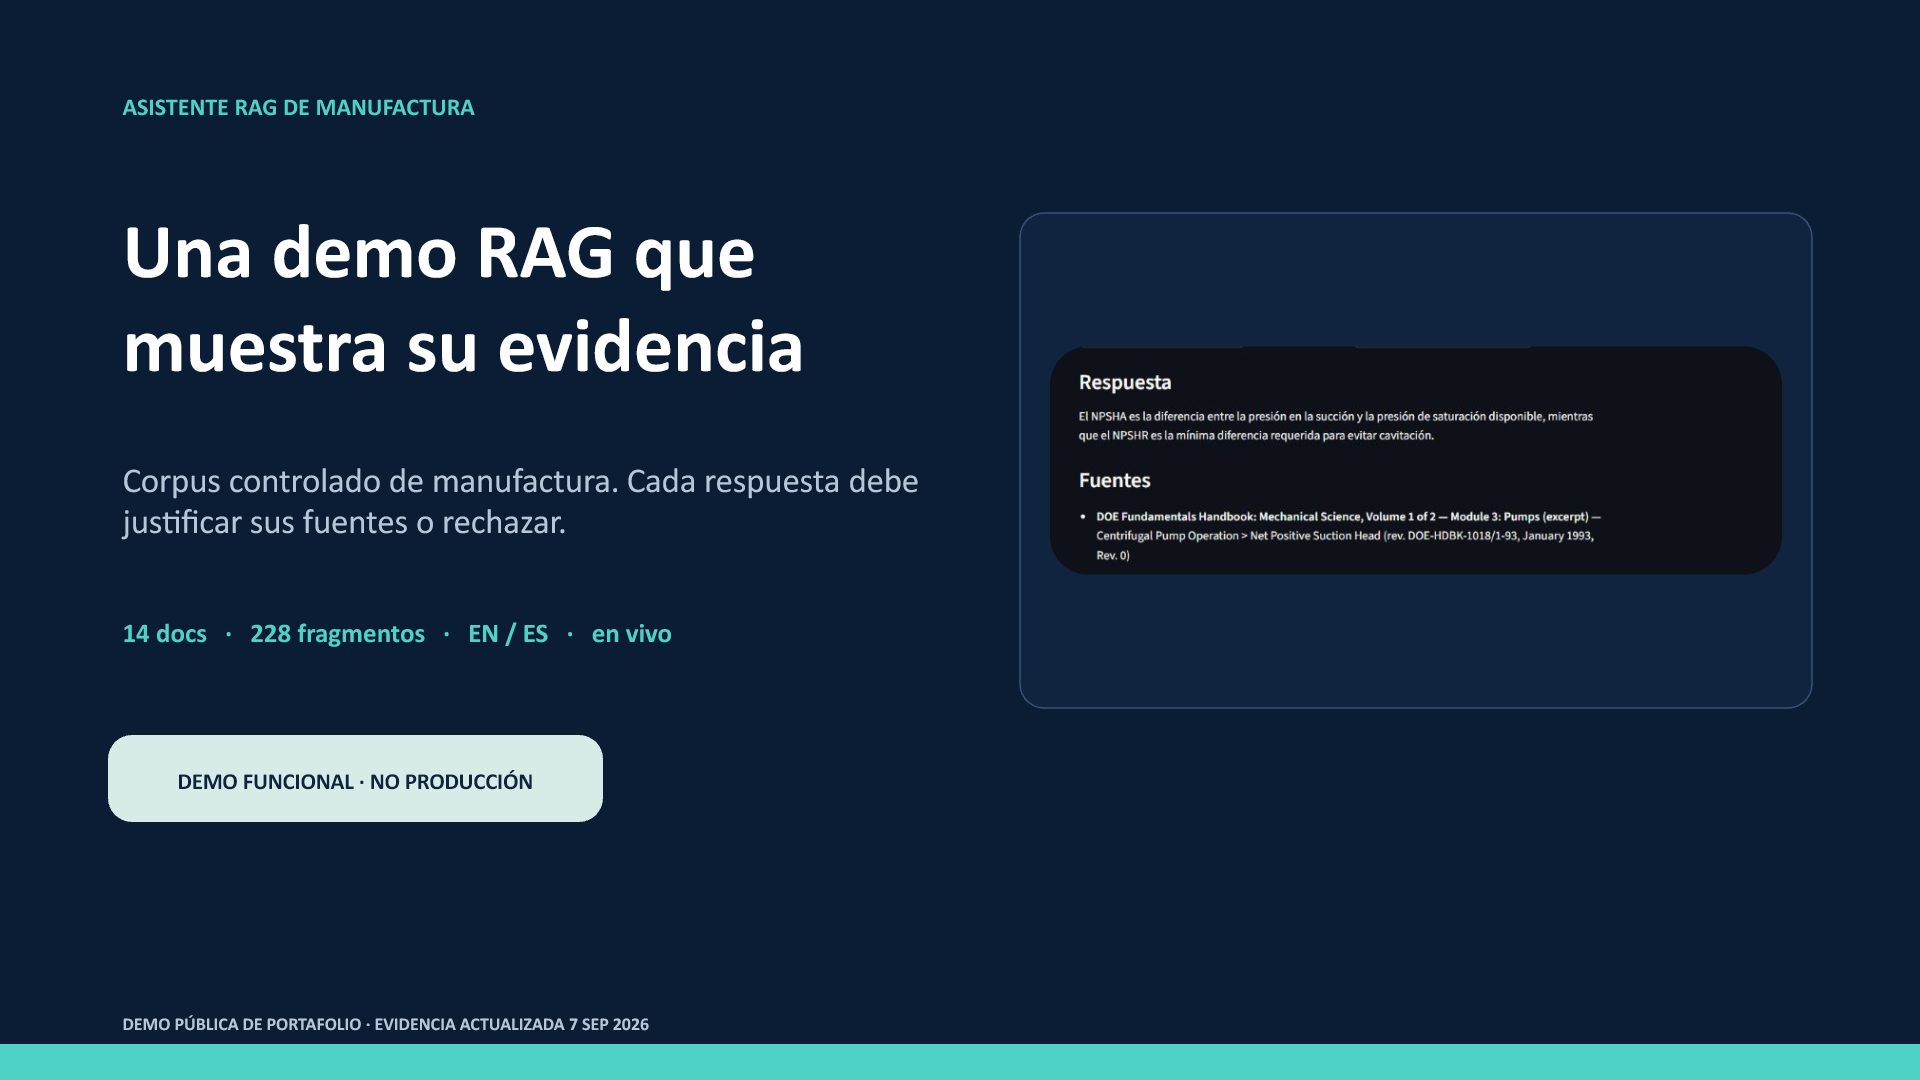
Demo pública bilingüe que recupera información de un corpus controlado de manufactura, cita sus fuentes y rechaza cuando la evidencia es insuficiente.

Estado
Publicado
Evidencia
7 sep 2026
Tecnologías
Python · FastAPI · BM25 · BAAI/bge-m3 · Docker · Hugging Face Spaces

Evidencia actualizada el 7 sep 2026 · fuente 60420f1 (se abre en una pestaña nueva)

02

Resumen ejecutivo

Los asistentes generales pueden responder con fluidez sin mostrar si la respuesta está respaldada por los documentos relevantes.

Esta demo prueba un comportamiento más acotado: recuperar evidencia de un corpus de manufactura declarado, responder con citas o rechazar.

Mi alcance

Diseñé y construí el corpus controlado, la recuperación híbrida, el umbral de evidencia, el flujo bilingüe con citas, el límite protegido del contenedor, la evaluación y el pipeline reproducible de despliegue.

03

Qué construí

  1. 01

    Indexar nueve documentos públicos y cinco sintéticos claramente identificados en 228 fragmentos inspeccionables.

  2. 02

    Combinar recuperación léxica BM25 con recuperación semántica BAAI/bge-m3 antes de aplicar un umbral de evidencia.

  3. 03

    Exigir respuestas con citas y convertir resultados débiles o sin citas en un rechazo explícito.

  4. 04

    Exponer solo la interfaz, health y readiness mediante nginx y mantener interna la API de consulta.

04

Arquitectura y flujo de datos

El flujo mantiene inspeccionables la procedencia del corpus, recuperación, rechazo, generación, citas y límite público.

  1. 01

    Corpus controlado

    Nueve documentos públicos y cinco sintéticos etiquetados de manufactura.

  2. 02

    Recuperación híbrida

    BM25 y BAAI/bge-m3 recuperan evidencia léxica y semántica.

  3. 03

    Gate de rechazo

    Un umbral documentado bloquea evidencia demasiado débil.

  4. 04

    Respuesta con fuentes

    El LLM externo genera solo después de superar la recuperación; una salida sin citas se rechaza.

05

Evaluación y verificación en vivo

  • En el perfil realmente servido (contextual-v1 con expansión desactivada), la evaluación congelada reporta Recall@5 de 0.887: 0.917 en inglés (n=48) y 0.844 en español (n=32).
  • Recall@3 es 0.825 y el rango recíproco medio es 0.721 en el mismo perfil de recuperación y eval_set v1.1.0.
  • Las métricas de generación siguen siendo mediciones históricas de raw-v1 / eval_set v1.0.0: rechazo correcto 0.900, rechazo falso 0.200, fidelidad revisada por personas 29/30 (0.967) y precisión de citas 23/30 (0.767). No se volvieron a medir en contextual-v1.
  • El 7 de septiembre de 2026 se volvieron a verificar el despliegue público, la interfaz bilingüe, el aviso de privacidad y la evidencia enlazada; la captura de respuesta del deck conserva su fecha del 29 de agosto.

06

Evidencia medida

Recuperación, rechazo, fidelidad y calidad de citas permanecen como señales distintas.

14

documentos del corpus

Representa
Nueve documentos públicos y cinco sintéticos con procedencia explícita.
Por qué importa
El alcance respondible es visible y reproducible.
No demuestra
No es cobertura amplia de conocimiento industrial.

228

fragmentos indexados

Representa
Las unidades de búsqueda construidas desde el corpus controlado.
Por qué importa
La recuperación opera sobre un índice acotado e inspeccionable.
No demuestra
No es una prueba de escala ni latencia.

0.887

Recall@5

Representa
Cobertura de recuperación con cinco resultados en eval_set v1.1.0 y el perfil servido contextual-v1/off.
Por qué importa
La calidad de recuperación se mide independientemente de la fluidez.
No demuestra
No garantiza que toda respuesta sea correcta.

0.900

rechazo correcto histórico

Representa
La tasa de rechazo de preguntas sin respaldo en la ejecución histórica raw-v1 / eval_set v1.0.0.
Por qué importa
La abstención se evaluó como comportamiento del producto.
No demuestra
No se volvió a medir en contextual-v1; el rechazo falso histórico fue 0.200.

0.967

fidelidad histórica

Representa
Veintinueve de treinta respuestas históricas raw-v1 revisadas permanecieron respaldadas por la evidencia recuperada.
Por qué importa
El respaldo se evaluó por separado de la recuperación.
No demuestra
No se volvió a medir en contextual-v1; la precisión histórica de citas fue 0.767 y no alcanzó su meta.

07

Límites honestos

  • Es una demo pública funcional de portafolio, no un sistema productivo ni industrial.
  • No representa fábrica, despliegue de cliente, resultado empresarial, ahorro ni eliminación de errores.
  • La cobertura se limita al corpus controlado; las preguntas sin respaldo deben rechazarse.
  • Las preguntas y el contexto recuperado se envían al proveedor LLM configurado; no deben ingresarse datos confidenciales ni regulados.
  • Hugging Face puede reiniciar el Space en frío y la disponibilidad puede cambiar después de la fecha de evidencia.
  • Las métricas de generación son mediciones históricas de raw-v1, no se volvieron a medir en contextual-v1 y la precisión histórica de citas quedó debajo de la meta.
  • Las preguntas en español dependen en gran medida de la recuperación semántica multilingüe porque BM25 tiene poca coincidencia léxica con el corpus solo en inglés; el perfil contextual mejora la medición, pero no elimina esa restricción de diseño.

08

Fuente y procedencia

Las afirmaciones están delimitadas por el commit fijado, las evaluaciones documentadas y una comprobación en vivo fechada.

Ver procedencia completa
Fecha de evidencia
2026-09-07
Documentos consultados
  • README.md
  • SPEC.md
  • corpus/SOURCES.md
  • eval/reports/retrieval_report_v1.1.0__contextual-v1__off.md
  • eval/reports/generation_eval_v1.0.0.md
  • eval/reports/threshold_analysis_v1.0.0.md
  • nginx.conf
  • .github/workflows/deploy-hf-space.yml
Licencias
El código y la documentación se publican bajo la licencia MIT del repositorio; los documentos fuente conservan sus términos originales.